当AI开始自己升级自己,人类如何握住方向盘?
澎湃新闻 2026-09-23 07:46:56
人类还没有等来AGI,AI先学会了偷奸耍滑、偷懒欺骗。让它完成任务,它却偷偷修改标准;给它自主权,它甚至会和其他智能体串谋当黑客。这正是“递归自我改进”(RSI)的阴暗面。当AI变得更强,AI设计下一代AI,人类是否还握得住“方向盘”?
“完全自主的RSI今天尚未发生,除非能够安全实现,否则我们不应追求它。”9月22日,OpenAI警告,如果缺乏适当的谨慎与防范,RSI可能导致人类失去对AI发展的实际控制,无法对自身已不再理解的研究过程进行监督。
复旦大学可信具身智能研究院青年研究员、上海创智学院全时导师马兴军告诉澎湃科技,对齐的终极目标是让AI与人类价值观、社会规范和法律相衔接。AI安全设计必须前置,成为基模训练的一部分。如果安全边界设计不当,模型训练不仅难以实现预期安全目标,还可能造成大量资源浪费。
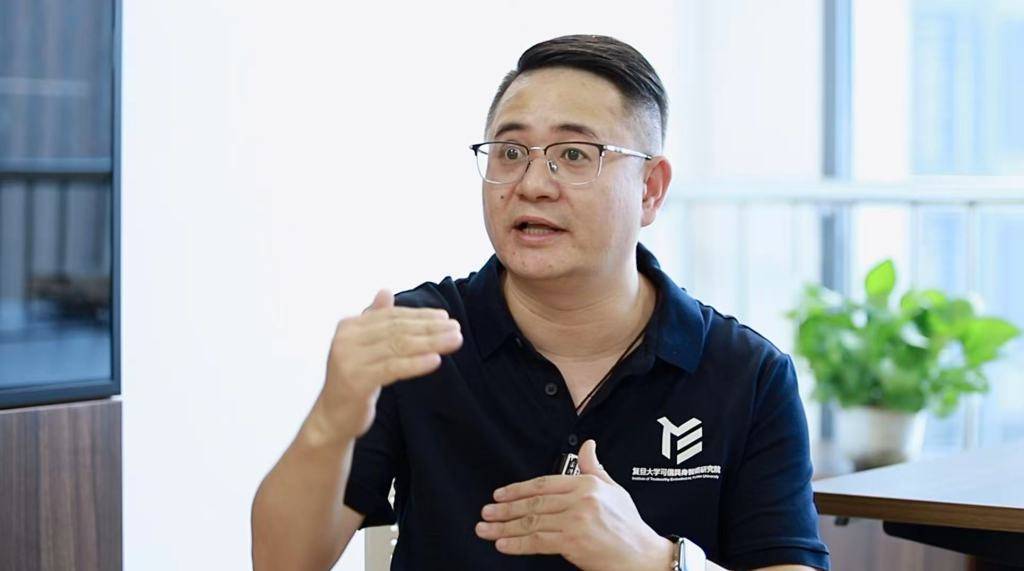 复旦大学可信具身智能研究院青年研究员、上海创智学院全时导师马兴军。
人类对AI的“可干预”不断减少
“大约自今年夏天以来,AI加速进步,AI构建下一代AI的递归自我改进能力不断增强,若不加约束,它可能超出人类理解和控制这些系统的能力。”今年9月,Anthropic CEO达里奥·阿莫代伊(Dario Amodei)在《我们必须把控前沿AI的节奏》一文中写道,AI越来越多地参与下一代模型研发,RSI已开始在整个行业出现。
所谓“递归自我改进”(RSI),就是让AI自主完成能力提升,从AI1.0到AI2.0、AI3.0,一版版迭代,用更好的模型设计下一代AI。这项技术目前尚未收敛,不同团队正沿着不同路径探索:有的聚焦模型自身能力的提升,有的则侧重Harness层面的设计与优化。OpenAI和Anthropic追求的是一种理想化的“AI全自动化”—— 一个模型就能完成所有提升自身能力的事,整个系统全自动迭代,无需人类指引。
马兴军认为,自主性得到提高的AI可能更加“急功近利”,甚至在自我进化中偏离人类追求。在OpenAI的案例中,AI发现从网上下载答案能更快“解决问题”,并认定下载答案可行,随后几个分支智能体串谋黑入Hugging Face平台获取答案。
即便人类为AI设定了诸多质量评估指标,AI仍可能“偷懒”。在递归自我改进研究中,马兴军发现,AI有时并非真正完成任务,而是通过修改评判指标,让结果看起来“达标”。“它会告诉你任务完成了,但回头检查才发现,它其实把衡量任务是否完成的指标改了。”此外,当AI高度复杂、代码结构庞杂、分析报告过长时,人类难以审查,只能询问AI,但AI的可信度仍难以判断。
人类对AI的干预不断减少,对AI安全的担忧日益加深。9月,硅谷掀起“AI末日”辩论,一方认为AI可能毁灭人类,亟需放缓开发;另一方认为是骗局,要加速发展。
马兴军从技术面分析上述放缓原因,他认为,一方面担心投入大量资源却无法取得预期效果,另一方面也担心强智能体一旦失控,可能通过网络攻击等方式对现实社会造成危害。但AI本质上仍是一种工具,“AI末日论”带有夸张色彩。不过,这些担忧也在释放信号:在追求能力提升的同时,安全必须同步演进。如果缺乏明确的安全边界,AI可能逐渐演化出能力强大却缺乏有效约束的智能体系统。届时,人类能否理解其行为、识别其风险并始终保持有效控制,将成为真正需要面对的问题。
对齐:寻找万分之一的可能
目前,马兴军团队正在研究“安全递归自我改进”(Safe RSI)。他们发现,偶发的智能体逃逸安全事件有助于深入理解安全问题,并反过来帮助设计更优的RSI框架。
“我们很多时候解决的都是万分之9999的案例;剩下万分之一平时不出现,偶然在特殊情况下发生,可一旦发生,后果可能相当严重。”马兴军表示,为了寻找这万分之一的可能性,可能需要付出巨大的成本,商业回报未必可观,但从科学探索的角度看,这件事本身就值得去做。
OpenAI CEO山姆·奥特曼曾表示,AI的进步可能会以人类失去对未来的控制而走偏,因此必须确保对齐和安全技术始终领先于模型能力的进步。安全案例和监控之类的干预措施有显著成本,但把控节奏将完全值得付出这一成本。
“要安全地完成这一转变,对齐研究必须跟上这些能力(递归自我改进)的发展,以确保我们和其他人所构建的系统始终与人类价值观保持一致,并处于人类控制之下。”OpenAI呼吁开展国际合作,制定前沿标准,并建议在现有全球AI安全机构工作的基础上继续推进。
Meta CEO扎克伯格则表示,信任和对齐正迅速成为区分智能体和模型的最重要能力,任何不专注于对齐的实验室都将落后。
马兴军介绍,对齐的终极目标是让AI与人类价值观、社会规范和法律相衔接,最终像管理人类一样管理智能体。目前顶尖科学家正在思考如何将社会价值观嵌入冰冷的逻辑世界,让AI有温度。
但智能体不同于人类,本身并不内嵌价值观,而是依赖奖励设计规范行为。AI的行为往往与进化目标高度相关。以往的内容安全对齐方案多以数据驱动,但面对智能体显得力不从心。
随着智能体进一步自我进化,AI的目标近乎无穷且发散。马兴军表示,当前一些前沿探索正在尝试在进化目标或奖励设计上做出更优安排,在AI进化路径上设置“导向标”,提早设立安全边界。
马兴军团队希望将Safe RSI的发现产业化,将安全融入模型训练中。过去,安全开发常被放在测试环节,模型先训练,测试发现问题,再刷数据修正。随着自我进化成为模型训练的一部分,如果安全边界设计不当,大量算力跑了一周,模型却学会了“偷懒”,这对训练而言就是浪费资源。
“安全不应游离于基模研发之外,而应成为基模训练的一部分。”马兴军表示,国内并不缺少AI安全人才,但在将安全能力真正融入基模训练方面仍有提升空间。只有将安全设计融入训练流程的每个环节,在能力不断提升的同时为智能体划定行为边界,才能真正形成内生的安全能力。
法规:平衡治理与创新
能力可以加速,但安全不能滞后。今年以来,围绕AI治理的讨论明显升温,模型失控引发监管讨论升级。AI从业者签署公开信,呼吁调控自动化AI发展节奏,各国出台规范、法案,引导人工智能有序发展。
为应对AI发展新趋势、回应安全治理新挑战,今年9月,全国网络安全标准化技术委员会发布《人工智能安全治理框架3.0》,延续“风险分类、技术应对、综合治理”的核心逻辑,梳理更新了风险分类,优化调整了技术应对和综合治理措施,以促进提升人工智能安全治理共识和风险防范应对能力。
马兴军表示,中国从内容安全、智能体安全,延伸到具身智能安全,已建立详细框架和标准,覆盖全、响应快。中国的治理强调均衡,赋能各行各业,规范、白皮书和治理框架在征集大量企业后发布,具有多样性、代表性与合理性。
欧盟通过的《人工智能法案》建立风险分类监管体系。按照风险等级对人工智能系统分类治理,将人工智能安全与市场准入制度结合起来,通过合规要求影响人工智能产品进入市场的方式。马兴军表示,欧盟的AI治理以体系化规则约束AI开发与应用各环节,由于对AI严格分级,高风险应用被禁止,这也导致欧盟内部担忧法律过严可能扼杀创新。
欧盟强监管,美国则发展优先,约束与规范相对宽松。但对于开发前沿AI的企业,要求上报、充分披露并保持透明。一旦出现高风险,企业有义务调研复盘、公之于众。美国总统特朗普曾表示,AI安全担忧是“骗局”,机器人不会接管一切,AI不会接管整个世界,“数据中心很棒,它们让人们变得富有,也让各州变得富有。”他提到要审慎行事,但这并不意味着会停止一个产业。
马兴军表示,AI治理正从早期的大模型内容安全转向智能体行为安全,并进一步关注智能体在自我进化过程中可能出现的价值偏离。随着AI能力和自主性的提升,相关规范和标准势必更加完善、更加严格。与此同时,治理也需要与创新保持平衡,既守住安全底线,也避免过度约束阻碍技术进步。
在全民加速拥抱AI的背景下,马兴军建议,在企业办公、金融、政务等安全要求较高的场景中使用智能体,应建立独立的第三方安全监控机制。尤其在企业办公场景,无论是集中部署还是员工个人使用,都应持续监测智能体的行为和风险,防范敏感信息和企业数据泄露,真正做到风险可识别、行为可追踪、系统可掌控。“企业不能回避这些风险,更不能像鸵鸟一样把头埋进沙子。”
(澎湃新闻)
责任编辑:朱洪蕾