质量月|人工智能时代如何守住AI评测质量关
大众报业·齐鲁壹点 2026-09-30 16:29:44
人工智能的快速发展,催生了层出不穷的智能产品,但如何保证产品的质量与安全,成为行业需要面对的新问题。
作为人工智能时代智能产品的“质量守门人”,这支团队以标准化评测体系为基石,一方面严守大模型、智能体等AI产品发布关卡,另一方面创新打造全维度大模型评测体系和配套工具,为各类智能业务场景落地提供了坚实质量保障。
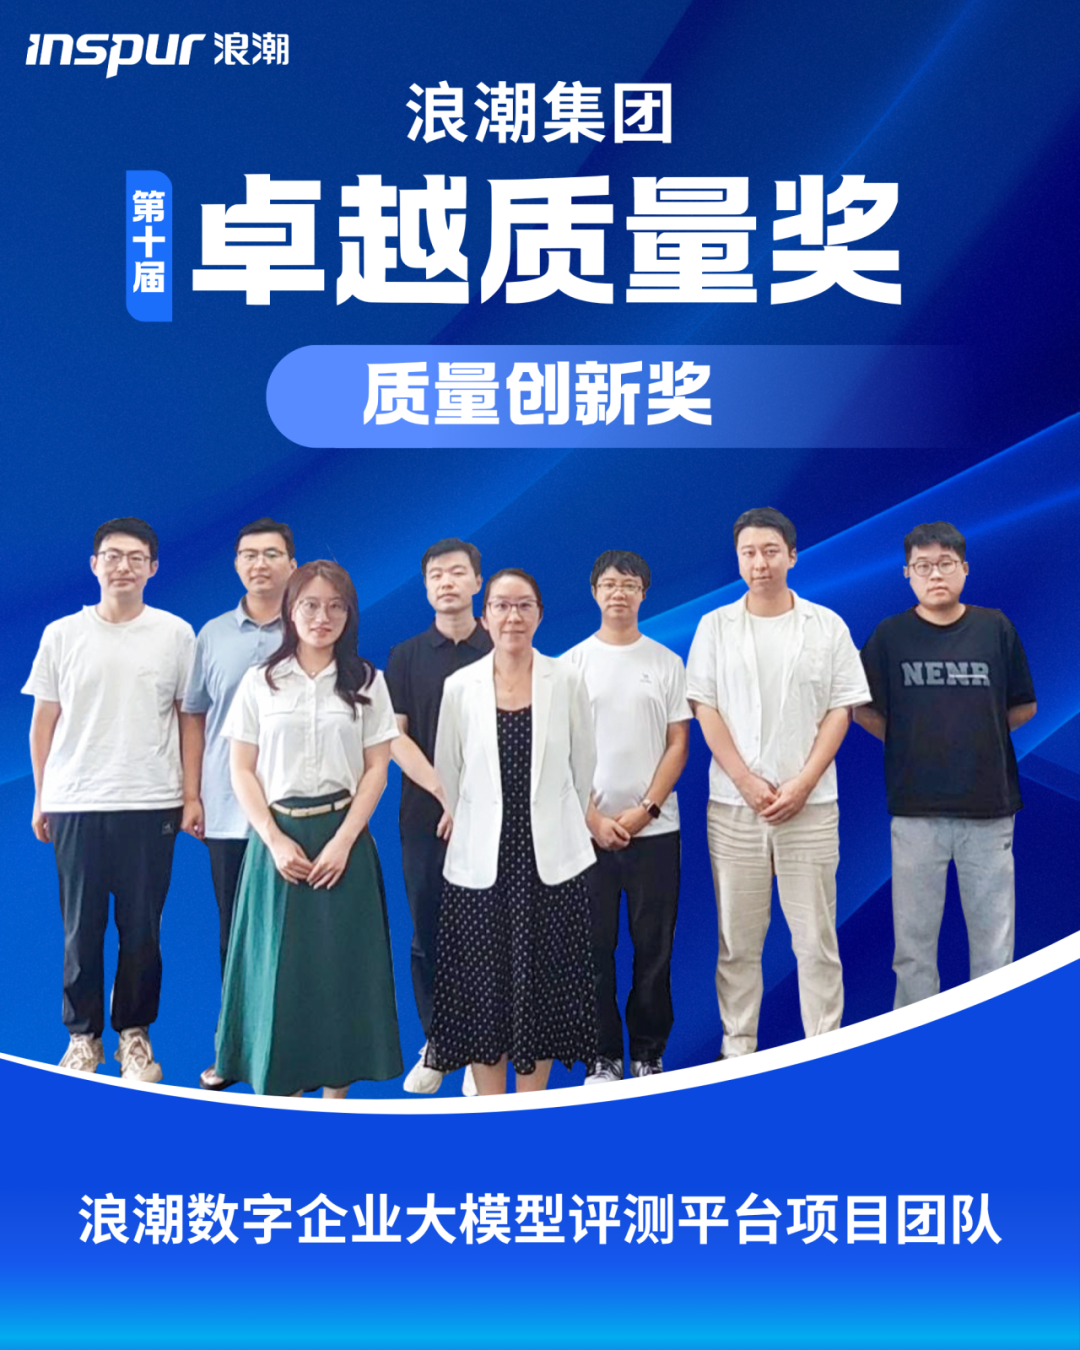
下面,一起来了解第十届“卓越质量奖”“质量创新奖”获奖者——浪潮数字企业大模型评测平台项目团队的故事。
标准先行,从零开始搭建大模型评测体系
当前,以大模型为代表的生成式人工智能加速落地,顺应这一趋势,浪潮数字企业陆续推出浪潮海岳企业AI、海岳大模型等核心平台产品,引领企业智能应用走向纵深。
新问题也随之而来:传统软件的运行逻辑是确定的,大模型则是基于概率采样生成内容,同一问题多次提问可能得到不同回答,传统测试非“通过”即“失败”的判定模式,难以适配AI产品的质量校验需求。
面对大模型“幻觉”和“不一致性”等质量风险,大模型评测平台团队决定依托公司现有研发体系,按照“定标准—建平台—持续迭代”的思路,一步步构建全新的大模型评测体系。
构建评测体系,首先要回答“评什么”和“怎么评”。因此,定标准是团队要进行的第一步。
当时业内尚无成熟的大模型评测范式可循,团队一方面从业务场景出发反向拆解评测的需求,另一方面主动向外取经,前往先进企业实地调研,了解从模型训练、微调到质量评测的完整流程,同时收集海外大模型评测的方法与思路,边学边试,逐步摸索出可行的路径。
在此基础上,经过多方案对比,团队最终确定了把“评测数据集+评测权重+自动化执行+AI裁判评分”作为核心路径,让评测标准既能覆盖真实业务场景,又能通过平台转化为可重复执行的自动化能力。
在团队看来,功能、性能、安全是大模型评测体系的三大核心方向:功能决定AI产品“能不能用”,性能决定“好不好用”,安全决定“敢不敢用”,三者缺一不可。
研发过程中,团队汲取传统测试的优秀经验,同时针对大模型特性做了关键创新,引入专属方法,用统计思维替代非黑即白的判定逻辑。
有了标准,团队便着手搭建评测平台,将评测标准转化为自动化执行能力,既节省了人力成本,也让评测可重复、可量化、可追溯。
体系落地不是终点,更要能够实现不断迭代,常用常新。团队深度参与IEEE国际标准、国家标准及行业规范编制,编制评测白皮书,持续补齐大模型与智能场景评测能力,形成“标准—平台—迭代”相互驱动的良性循环。
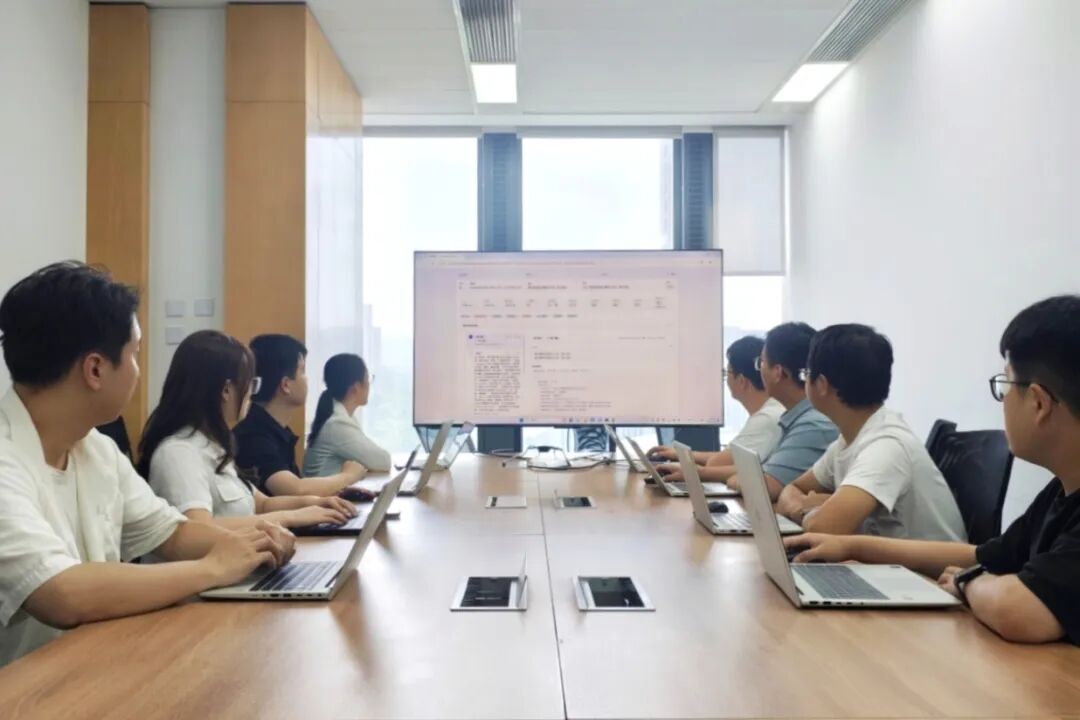
团队成员方案交流
技术破局,攻克评测效率与质量瓶颈
大模型评测体系建立后,如何高效、保质地执行下去,成为新的难题。
大模型及其衍生场景版本一周可能迭代数次,纯人工评测难以跟上节奏。加之输出具有概率性,同一问题多次提问答案可能不同,传统自动化手段难以全面覆盖,结果校验也困难重重。
针对这些难点,团队不断展开头脑风暴,最终提出了“AI对抗AI”的思路——大模型回答的内容,交给裁判AI来判定。
海岳大模型评测平台便在这过程中逐渐建立起来。
依托海岳评测体系与浪潮海岳PaaS底座,平台融合多项人工智能等技术,将评测规则、标准等转化为自动化能力,实现“AI裁判评测AI”。
同时,平台能有效评估大模型泛化能力、输出稳定性等核心指标,评测效率提升4倍以上,后台7×24小时异步执行,覆盖数十类业务场景,全程无需人工值守。
在某问数项目中,重复性人工操作减少了90%以上,评测数据、得分、能力图谱全程可量化、可追溯,大幅节约了交付验证时间。
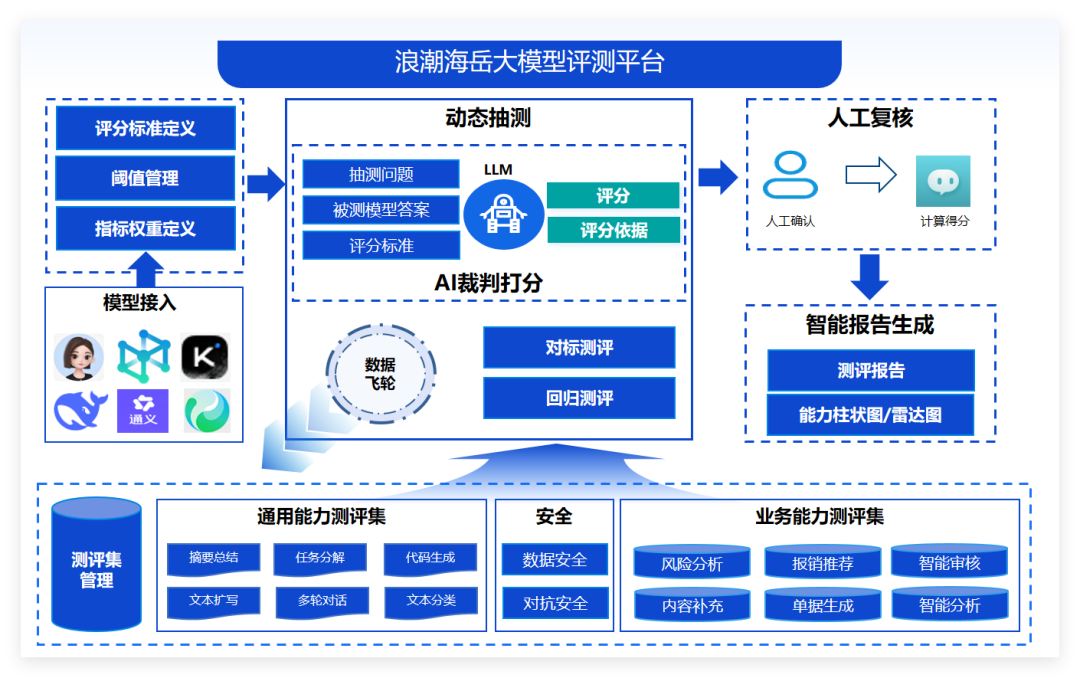
海岳大模型评测平台
场景攻坚,应对智能体评测新挑战
企业级智能体的出现与发展,又给团队带来了新挑战。
与大模型不同,企业级智能体不只是“说”,还要“做”:点按钮、填表单、跨系统操作、人机交互。
因此,如果把大模型评测比作“批改试卷”,看它答得对不对、好不好,那么企业级智能体评测则像是在“为实操考试打分”,评测对象从文字答案变成了一整段操作过程。
这给评测带来了三重挑战:一是界面动态变化,不同客户、版本、权限下界面元素位置和样式各异,传统自动化脚本维护成本极高;二是过程同样关键,“结果对、过程乱”在企业场景中意味着风险不可控;三是结果校验需穿透页面表象,确认业务状态真正变更——页面显示“成功”不等于业务真的成功。
团队最初尝试用传统方案应对,却发现越走越窄。后来,一个“反直觉”的想法成为解开谜题的线索:相比于“让评测平台去适应界面”,“让界面主动‘告诉’评测平台它是什么”更为可行。
基于这一思路,团队将界面元素抽象为可识别的语义节点,构建动态界面适配层,在界面变化时平台可自动识别。
在此基础上,团队为智能体操作实行了全轨迹监测:记录每一步操作、页面变化和中间状态,及时发现无效操作和异常分支。
最后一道难关是执行结果校验。为保证结果正确的同时,过程也能合规,团队构建了五层校验体系,五层联动,确保业务能完整跑通。
历经这三道难关,团队最终打造出了Mano智能体评测工具,能够用企业级操作类智能体专属评测能力,满足全产品智能化评测需求。
同心聚力,筑牢AI质量安全防线
从零搭建评测体系并持续完善,到大模型评测平台、Mano智能体评测工具落地,团队在探索中形成了“牵头小组统筹把控、研发人员技术攻坚、测试人员夯实底座”的高效协作模式。
团队的牵头小组统筹把控产品架构与标准体系建设、逐一攻克技术难点;研发人员专注平台功能迭代与场景适配,搭建自动化评测全链路工具能力;测试人员持续推进数据集规整扩充、模型实测与结果校验,保障评测工作规范落地、数据精准有效。
三大工作模块高效联动,实现了标准体系与工具平台深度融合。
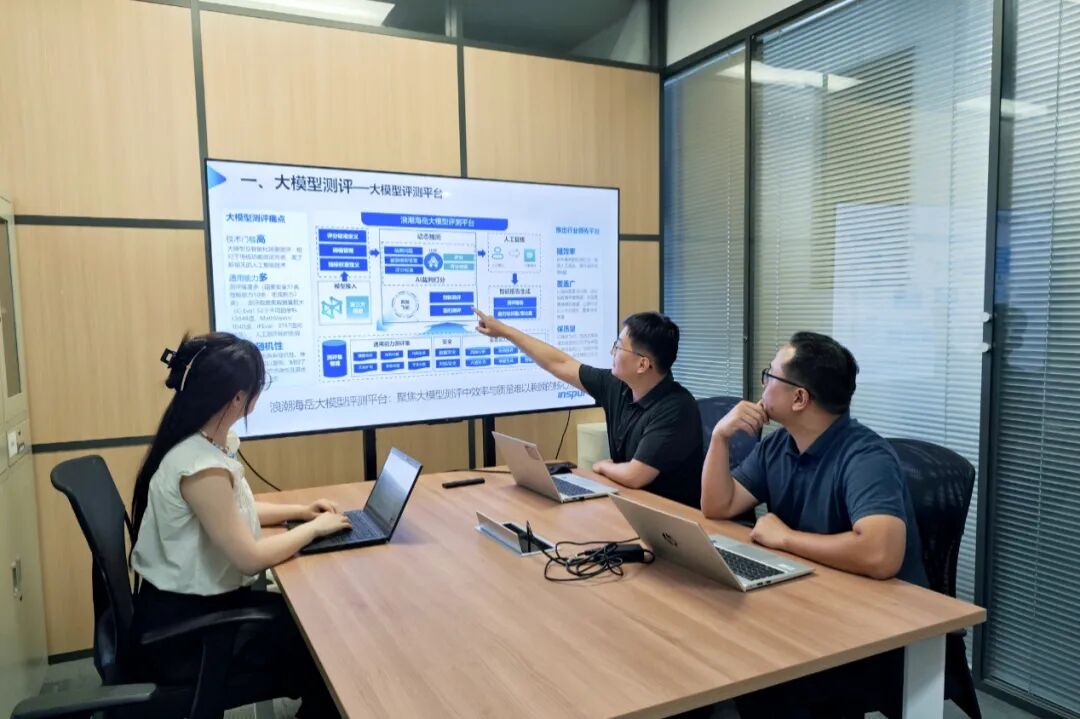
团队成员组会交流
目前,大模型评测平台可全面支撑大模型、智能体、智能场景、数字员工等多种评测场景,有效解决了传统人工测试效率低、评测复杂、评测集数量不足等问题,已顺利支撑百余项智能业务场景评测工作。
项目成果先后斩获2025年山东省质量标杆、全国电子信息行业典型案例等多项行业荣誉。
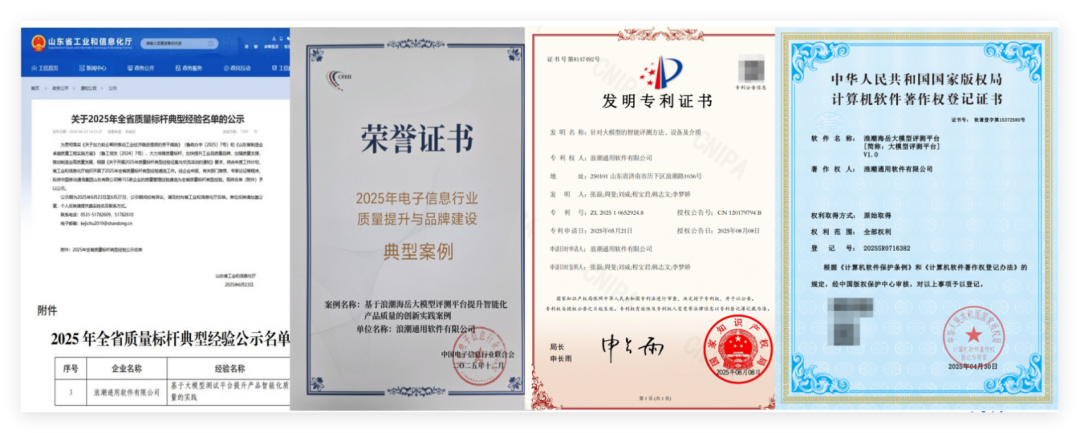
团队荣誉证书
步履不停、笃行不怠。浪潮数字企业大模型评测平台团队将持续迭代评测体系、提升平台能力,立足公司核心业务,拓宽拓深企业级AI应用评测覆盖范围,严守产品质量关卡,全力护航ERP产品智能原生转型。
责任编辑:杨绪彬