
常江 刘亮:资源把关:生成式人工智能的新闻调用及其治理
青年记者 | 2026-10-29 08:27:51 原创
作者:常江(深圳大学传播学院教授、深圳大学全球传播研究院研究员,本刊学术顾问);刘亮(深圳大学传播学院硕士研究生)
来源:《青年记者》2026年第10期

导 读 :
生成式人工智能正在将新闻消费从用户抵达来源转向智能系统调用来源。本文以新闻机构推出的爬虫政策、授权协议和接口实践为研究材料,提出“资源把关”解释框架,将其界定为围绕新闻内容的机器可调用资格所展开的制度化生产与控制。
一、引言
2026年6月,路透社和《时代》周刊被报道正在对人工智能机器人采取“默认拦截,白名单放行”的访问政策。路透社相关负责人将这一调整解释为新闻价值投入与所得回报之间的失衡:自动化系统可以持续读取并调用新闻内容,来源网站却未必获得相应的流量、署名或商业收益。[1]一个月后,路透社宣布推出模型上下文协议(MCP)服务器,使订阅客户的人工智能代理能够在授权范围内检索、调用及下载路透社新闻。[2]通用抓取受限与认证接口开放同时出现,表明新闻机构并非简单拒斥生成式人工智能,而是在网页公开与机器使用之间重设进入条件。
类似变化已然超出个别媒体的策略抉择。路透新闻研究院对10个国家中最常用的15个在线新闻网站进行调查,发现截至2023年底,约48%的受调查网站已屏蔽OpenAI的爬虫。[3]与此同时,用户通过聊天机器人接触新闻的比例开始上升,新闻出版商也预期搜索流量将承受进一步压力。新闻网站仍面向公众开放,但搜索爬虫、训练爬虫和用户代理能否读取同一页面,已经可以被分别规定。新闻的“公开”与机器的“可用”由此分离。
把关研究为理解这种特殊的控制提供了起点。经典理论关注新闻事实如何通过组织内部的“门”成为报道[4];网络把关与当代数字把关研究把行动者扩展至用户、平台和算法,说明信息控制可以分布在多个技术与组织节点[5][6];算法把关研究进一步揭示,分类、排序和推荐规则并非中性的技术程序,而会把特定价值写入可见性分配。[7]近期研究已将生成式人工智能视为贯穿内容生产、中介和接收环节的系统性把关力量,并推动新闻研究进入模型架构、数据基础与更广泛的人工智能生态[8][9]。这些研究显著扩展了把关的主体与环节,但其分析焦点仍主要落在新闻内容如何被生产、过滤、重组和呈现上,模型能够调用哪些新闻来源则构成分析的前提。
本文关注的正是这一前提如何形成。一个模型没有抓取资格、实时检索权限或授权数据库接口,即使能够筛选和整合内容,也无法在答案中使用相应新闻。这里的理论缺口不是“模型筛选之前还有一道门”这样单纯的时间前移,而是控制对象发生了变化:编辑把关和算法把关主要在既有信息中进行取舍,资源把关则规定新闻能否进入选择范围。前者分配内容的呈现机会,后者生产可被选择的对象。基于此,本文提出“资源把关”解释框架,尝试理清其与编辑把关、平台把关及生成式把关在控制对象、决策单元和权力结果上的差异,考察新闻机构提出的机器访问边界如何经由身份认证、用途许可和接口执行转化为实际规则,并进一步分析规则提出权、技术执行权与候选集组织权分配,以及这种权力配置在何种条件下改变生成式新闻的来源结构。
二、从内容选择到资格生产
在既往研究中,把关只有存在可供选择的对象时才会发生,但这些对象如何进入选择范围,往往被视为不言自明的前提。生成式人工智能介入用户新闻消费令这一前提得以显现。换言之,新闻在被模型筛选和组织之前,首先要成为机器能够接近和处理的对象。要理解这种从内容选择到资格生产的转变,需要考察新闻使用入口如何从人的访问转向机器调用,进而区分新闻文本、数据形态和可调用资源,并据此说明资源把关与编辑把关、平台把关及生成式把关之间的机制差异。
(一)新闻使用入口的机器化
传统搜索引擎与生成式智能体都需要读取外部新闻网页,但二者对新闻内容的处理目标不同。传统搜索主要根据页面与查询条件的相关性作出判断,再以链接列表、标题和短摘要呈现搜索结果,用户仍需抵达来源页面完成阅读。生成式搜索和对话智能体则可以先行检索多个来源,完成比较、提取和概括,再以连贯答案回应用户。用户不必理解新闻链条,也无需在多个网页之间移动,在大多一般性问题中,信息消费可以直接在智能页面内完成。[10]突发新闻、独家报道和深度材料仍可能把用户带回原文,但“抵达来源”已不再是一般性信息消费的必要环节。[11]
入口变化不仅代表着平台再次截停流量,其带来的直接后果是智能体能够替代用户完成原本需要用户亲自进行的提出检索式、筛选来源、判断相关性、提取事实并组织理解等一系列新闻使用劳动。传统平台主要影响用户先看到哪条新闻链接,生成式系统还能够控制哪些材料进入答案、不同来源如何被概括以及用户是否仍有必要阅读原文。由是,新闻机构与用户建立直接来源的关系被切断。新闻内容仍被使用,使用行为却不再表现为点击、阅读、订阅或者评论,原本可以被媒体识别的用户联系被转化为智能系统内部的一次调用。
(二)新闻资源的关系性界定
新闻作为一种传递信息且符合专业主义规范的特定叙事文本,在面向人类阅读的页面展示中往往涵盖标题、正文、图片、版面位置、作者署名和发布时间等重要文本标识。机器进入后,新闻需要被清洗、切分、索引和匹配,完整的新闻作品由此被转化为可供计算和调用的数据化材料。本文所提的“新闻资源”,不是新闻文本、数据化材料和模型候选来源的混称,而是数据化材料在特定机器身份、特定使用目的和特定权限条件下取得可调用资格后的关系状态。换言之,资源不是内容固有的属性,而是新闻来源与机器使用者之间经由规则确认所形成的资格。一个结构化文本若不允许某类机器用于某种目的,仍不能成为任其调用的新闻资源。
对这一概念的界定能够进一步区分机器访问的不同用途。OpenAI就公开区分用于模型训练的GPTBot、用于网页搜索的OAI-SearchBot以及响应用户需求的ChatGPT-User,并允许网站分别管理相关访问。因此,同一篇公开报道可以面向人类阅读,可以被搜索索引,却未必同时被允许进入训练;它也可能在订阅客户触发的代理任务中可用,却不能被通用爬虫批量获取。新闻开放由单一的页面可达性,分化为阅读、索引、训练、生成呈现与代理操作等不同关系。
新闻被转化为可调用单元后,完整作品的边界也会松动。模型可以从报道中提取事实片段或将多个来源压缩为一段背景说明,而标题、署名、更新时间和更正信息未必与事实片段同步保留。[12]机器获得的是专业生产的文本结果,采访、核实、法律审查和编辑责任等过程则处于系统视野之外。资源把关因而不只是版权许可问题,还涉及来源、更新与责任信息能否随内容进入后续新闻知识生产。
(三)资源把关的差异化机制
既有把关理论已经能够解释多主体、算法和基础设施对信息流的控制,因此,仅仅把研究对象从“内容”转向“资源”,或者把考察环节前移至模型生成之前,尚不足以证明“资源把关”有别于其他把关形式的差异化。具体而言,其差异化体现在如下几点(见表1):控制对象是机器可调用资格,而非新闻事实或答案内容;决策单元是“来源—机器—用途”的关系组合,而非单条内容;执行机制以身份认证、许可配置和接口权限为主,而非编辑取舍、排序或生成;直接结果是候选集边界及“资格性缺席”,而非曝光量或答案表述。
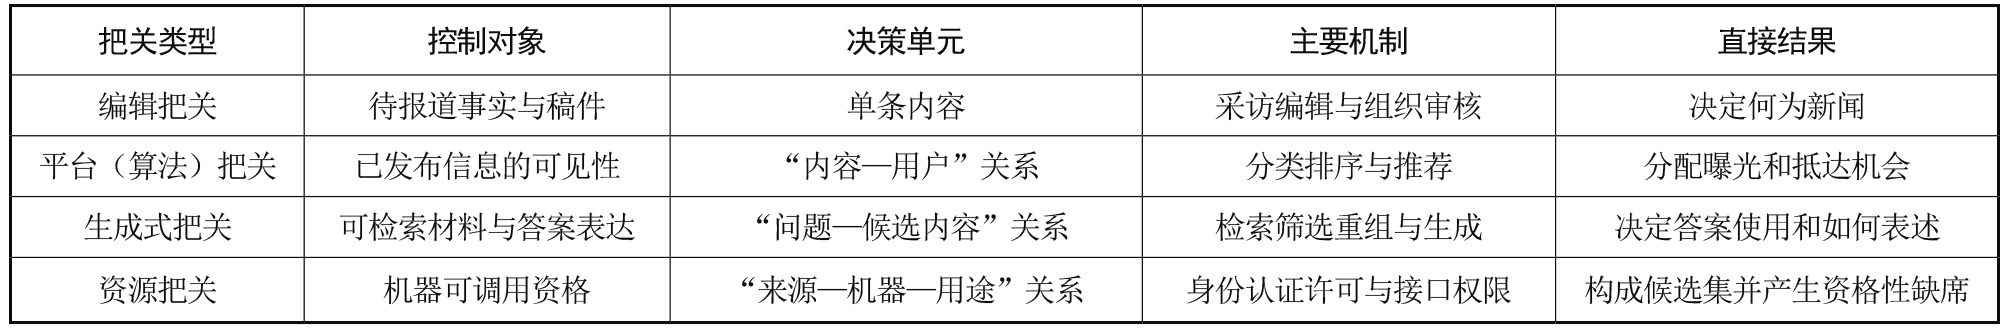 表1 资源把关与相邻把关机制差异化比较
资源把关先行构成“什么可以被选”,生成式把关再在候选范围内决定“选什么、怎么组合和怎样表述”。因此,资源把关与生成式把关不是相互替代的概念,两者可以由不同主体控制,也可能在同一人工智能平台内部接续发生。资源把关的理论意义不在于将传播链条机械切断,而在于说明:候选集本身不是自然存在的技术容器,而是制度、合同和基础设施共同产生的结果。
三、机器可调用资格的规则配置
资源把关并非新闻机构在服务器入口独立完成的一次判断。新闻机构可以声明限制抓取,却需要人工智能企业披露机器人身份,需要基础设施服务商识别和阻断访问,也需要行业标准和商业合同把使用要求转化为可执行任务。其核心并非判断某条报道是否有新闻价值,而是确定何种机器能够基于何种用途、以何种范围和频率调用已发布的新闻。
(一)机器身份的关系认证
资源把关的第一步就是把隐藏在网络请求之后的自动化访问者转化为可识别、可追溯的行动主体。同一人工智能企业可以运营训练爬虫、搜索爬虫和用户代理,第三方还可以调用模型形成新的代理服务。只识别企业名称而不区分具体机器人,新闻机构便无法判断一次访问的具体用途。具体而言,这里的“身份”不仅是通常意义上的技术标识,更强调机器与新闻机构的一种关系资格。只有当机器能够被追溯到明确运营者、具体用途与责任主体时,新闻机构才可能提出授权、署名、访问频率和纠错等一系列要求。在这一过程中,技术门槛由“能否读取网页”转向“能否证明自己是被允许的访问者”。此外,身份声明并不自动等于真实身份,爬虫协议也主要依赖企业的自愿遵守[13];认证能否成立仍取决于IP范围、签名、日志和异常检测等基础设施条件。
从新闻生产与分发这一更广泛链条来看,对机器身份的识别过程亦是把关的重新分配过程。新闻机构可以声明媒体自身的准入要求,但机器身份的验证通常依赖云服务商、内容分发网络和人工智能企业提供可验证标识。若基础设施无法区分机器人用途,媒体只能整体放行或整体封堵;而只有识别愈发精细,差异化开放才更可能实现。
(二)机器用途的分层许可
机器身份得到识别之后,把关判断还需要落实到机器调用新闻的具体用途上。用于公开搜索的索引、用于模型训练的持续复制以及代表用户完成实际任务的代理调用,对新闻资源的需求范围、更新频率和替代效应并不相同。若将此类行为统称为“人工智能使用”,许可条件便过于粗糙,也无法解释媒体为何允许某些机器人进入而将另一些机器人屏蔽在外。这样一来,对机器用途进行分层许可就显得很有必要。
基于当下用户的新闻消费惯习,可将新闻页面开放划分为三个相互关联但不必同步的层次。第一层是面向人的阅读可达性,即用户能否直接打开网页、触及内容;第二层是面向机器的识别可达性,即系统能否读取标题、元数据、图频内容和页面结构;第三层是面向模型的使用可达性,即内容能否进入训练、实时检索、生成展示和代理任务。因此,公开新闻不再对应一项不可分割的“访问权”,而是被拆解为具有不同条件的调用关系。
这种拆分并不等同于把公共新闻转化为封闭的数据库。新闻具备公共讨论与社会监督的独特作用,新闻媒体不能以机器访问为由任意削弱公众的信息权利。反之,机器具有规模化复制、自动化整合和替代性呈现的能力,也不能被简单等同于单个读者。资源把关试图建立的,是公众接近新闻与自动化系统再使用新闻之间的制度区分。其正当性取决于用途分类是否清楚、限制是否合比例,以及规则是否会不当妨碍公共利益用途用,而不能由媒体单方主张而自然获得。
(三)调用条件的接口执行
机器接入规则最终能否形成稳定关系,取决于机器使用之后能否产生与资源投入相对应的回报。这里的回报不限于一次性授权费用。新闻机构还关心来源名称是否稳定显示、用户能否抵达原文链接、调用规模是否可统计、新闻更新是否会同步进入答案,以及平台使用内容的范围是否超出协定。若授权只解决“可以使用”,却不解决“如何呈现”和“如何返回”,新闻机构仍有可能成为有偿但不可见的后台供应者。
具体到当下人工智能企业与新闻机构的关系,OpenAI宣布与Axel Springer、Le Monde和Prisa Media新闻组织推进智能新闻生产方面合作,把内容使用、模型训练、答案展示、来源标注和原文链接纳入同一安排[14][15]。这些合作未公开完整的商业条款,也不能代表所有新闻机构与人工智能企业的关系,但从实践层面表明,机器接入开始由事后默认抓取转向事前协商。此外,美国科技公司Cloudflare推出的按抓取计费工具允许内容所有者对不同爬虫选择免费放行、收费访问或完全阻禁,试图将机器的自动化读取转换为可记录、可定价、可追溯的资源交换。[16]由此可以看出,授权、署名和计费不再是彼此分离的议题,而是共同构成机器调用的接口条件。
路透社的模型上下文协议服务器进一步呈现了接口在生成式人工智能与路透社新闻交互关系中的作用。通用爬虫被默认阻止后,订阅客户的智能代理仍可以通过经认证的接口检索和下载其已购买的新闻资源。基于此,开放不再建立在网页全面暴露之上,而建立在客服身份、订阅权限、任务范围和访问记录之上,是一种以调用主体、权限层级、使用目的和技术合规为条件的选择性开放。[17]对于智能体而言,这种结构化接口比网页抓取更稳定,也更适合自动化工作流,满足用户的个性化需求;对新闻机构而言,接口能够控制内容范围、记录调用并维持合同关系。因此,阻断未经协商的抓取与建设授权接口不是相互抵消的动作,而是共同完成从“默认提取”到“受控调用”的转换。
四、资格生产的权力机制与公共性后果
资源把关无权直接决定生成式人工智能如何在答案界面表述新闻,却通过构成候选集间接影响了答案新闻生成的条件。沿此逻辑,资源把关可被理解为候选集资格生产过程中的权力协商与博弈。在这一过程中,有关新闻的公共性考量应当被放置在机器调用的现实情境中予以反思。
(一)专业判断的技术化转移
新闻专业判断原本体现于采访核实、信源选择、编辑审核和更正机制,并通过媒体署名、报道文体与组织声誉获得社会识别。生成式人工智能的出现并未取消这套专业生产过程,却改变了它进入传播系统的方式。大语言模型无法直接观察并呈现新闻报道的生产过程,只能操作加工已经转化为数据结构的文本、元数据、来源标识及更新记录来进一步生成信息。[18]新闻专业性因而不能仅以新闻报道已经发布为存在形式,还必须被转换为模型能够识别和调用的资源属性。
在算法在新闻自动化分发和生产中日益普及过程中,有关算法判断与新闻专业判断的讨论从未停息。有学者指出,算法判断并非新闻专业判断的简单延伸,而是建立在数据分类与计算规则之上的另一套知识评价体系。[19]资源把关使两者在新闻调用环节发生衔接:新闻机构通过来源标识、权属说明、内容标注、更新记录和结构化接口,把采编环节形成的专业判断写入机器可处理的数据结构。新闻专业性并未被技术取代,但其能否被模型识别,愈发依赖技术表达。此外,这种新闻专业性转译亦会形成专业价值与机器可用性之间的差异。例如,一篇报道即使具备原创性和现场性,如果缺少清晰的权属信息、机器可读格式或稳定接口,也可能无法进入模型的候选资源范围;综合性媒体的报道未必最接近事件现场,却可能因数据结构规范、更新机制稳定而被持续调用。由此,新闻价值仍是报道成立的基础,却不再是取得机器候选资格的充分条件。
人民网建设“主流价值语料库”可以在这一逻辑下得到解释。从深层次来看,新闻机构正在主动把内容审查、价值判断和来源责任转换为可供模型识别的资源结构。经过筛选、标注和结构化处理的新闻语料,将原本附着于新闻生产过程的专业判断写入数据组织形式,令新闻机构不仅生产新闻报道,也参与定义何种材料具备进入模型的技术资格。不过,这种资格仍需得到人工智能企业和接口系统的识别。因此,所谓技术化认证并不意味着新闻权威的自然延续,而是指专业判断必须经过技术标准的再表达,才能进入生成式把关的后续环节。资源把关的治理任务之一,正是防止格式完整性被误作专业可靠性,同时要求模型保留足以支持来源核验和更正传播的信息。
(二)三类权力的不对称衔接
新闻机构可以通过版权声明、爬虫协议和授权合同规定机器使用条件,但这些规则声明本身不等同于把关权,亦不会改变新闻资源流向。只有当访问主体能够被识别、使用目的能够被区分、违规访问能够被阻断时,访问规则才取得实际把关效力。资源把关因此依赖云服务、内容分发网络、身份认证系统和数据接口,并将组织意愿转化为技术权限。而恰恰是在这一过程中,把关权开始向基础设施节点集中。
平台研究已经说明,数字平台的权力不仅来自其拥有大量用户,还来自其把接口、标准、数据存储和连接能力转化为传播活动不可回避的基础设施。让-克里斯托弗·普朗坦(Jean-Christophe Plantin)等人将这一过程概括为“平台的基础设施化”与“基础设施的平台化”,即平台一方面获得基础设施所具有的稳定性和普遍依赖,另一方面又保留私人企业对规则、接口和商业模式的控制。[20]在新闻领域,有研究者进一步提出“基础设施俘获”的问题,即新闻机构即使保持编辑独立,也可能因分发、数据分析、广告和技术服务依赖而受到平台基础设施的结构性制约。[21]这一问题在资源把关中表现为规则制定权与执行权的分离。媒体可以决定是否许可自身内容被使用,却未必掌握身份验证、访问统计和大模型阻断的通用技术。
三类主体的权力虽相互依赖,但并不对称。新闻机构拥有局部否定权,可以拒绝特定机器使用自身内容,却难以要求模型必须采用其报道;基础设施平台拥有规则执行权,决定访问边界能否被准确转化为认证、阻断和记录,并同时作用于大量网站;人工智能企业则掌握候选资源的组织权,决定获得许可的新闻是否进入检索架构。网络把关研究表明,把关能力与行动者的网络位置、信息生产能力、相互关系和替代选项有关。[22]机器行为研究也提示,机器并非脱离组织和规则而独立行动的中性工具。[23]因此,多元主体共同把关不足以概括这里的权力结构,关键在于三类权力的作用范围和可替代性不同。
资源把关由此形成“控制回收与依赖转移”并存的局面。新闻机构通过白名单和授权接口收回部分内容控制权,却又需要依靠外部基础设施识别机器、执行规则,并需要人工智能平台将其纳入实际检索。资源把关没有使新闻机构重新成为中心守门人,而是将把关权分置于资格声明、技术执行和候选集组织等节点,并使掌握通用基础设施与模型入口的主体获得更强的结构性位置。
(三)新闻公共性的条件效应
资源把关令新闻公共性的实现不再只取决于报道是否公开,还取决于报道是否进入生成式信息入口。报道即使面向公众开放,只要缺少相应许可、机器可读格式或接口支持,依旧无法进入答案的候选集。这种缺席不同于算法排序中的低可见性。塔伊娜·布赫(Taina Bucher)讨论的“不可见性”(invisibility)发生在内容进入平台之后,资源把关造成的则是准入之前的资格性缺席。[24]地方报道未出现在答案之中,不一定是模型在比较后认为其相关性较低,也可能是其从未取得可供比较的资格。
在新闻算法推荐研究中,接触多样性被视为推荐系统事件新闻公共价值的重要准则,但接触多样性以候选来源本身具有多样性为前提。[25]如果可调用资源主要来自权属明确、格式统一并能规模化供给语料的大型机构,模型即使在这些来源之间均衡分配注意力,也无法恢复此前被排除的地方知识和中小媒体报道。因此,生成式新闻的来源多样性至少包含两个层次:哪些来源取得候选资格,以及模型如何在候选来源中选择。
一项针对生成式搜索的跨语言研究发现,西方大型智能系统虽然会使用专业新闻媒体,却可能高度依赖英语来源并弱化区域视角,且伴随误归因问题。[26]因此,候选来源结构值得被单独审查,但也不能据此反推所有准入标准都会导致集中。具体而言,当合法来源、稳定接口和可追溯要求需要较高的法律、技术与合同成本,而行业又缺少低成本共用接口、互操作标准、媒体联盟或公共支持时,组织能力差异才更可能转化为机器可选资格差异,并强化来源集中趋势。
此外,资源把关同样可能改善而非削弱新闻公共性。身份认证可以减少冒名抓取,来源标注和调用日志有助于追溯错误,稳定接口能够同步更新与更正,合理的许可回报也可能支持专业新闻持续生产。一言以蔽之,问题不在“资源把关越少越公共”,而在准入规则是否透明、可申诉、可互操作,是否给不同规模的新闻机构提供比例适当的接入路径。资源把关的规范目标不是让所有来源得到相同调用结果,而是避免资格条件在缺少正当理由时排除某类来源,并保证专业来源能够以可追溯、可纠错的方式进入候选范围。
据此,治理重点需要从模型输出延伸至候选资格形成过程。人工智能企业应说明来源纳入与排除的基本条件,并提供来源纠错、退出和更新机制;基础设施提供者应提高机器身份标识与用途声明的可验证性,避免把商业平台的私有分类变成事实标准;行业组织和公共机构则可建设低成本共用接口、标准化授权表达与集体协商机制,降低地方媒体和中小媒体取得机器可选资格的制度成本。
五、结语
生成式人工智能对新闻把关的改变,不只是把最终选择权交给模型,也把一部分控制前移到“何种新闻有资格成为模型的选择对象”这一环节。本文以“资源把关”概念化这一机制,试图区分在既定候选集内选择内容与生产候选资格、划定选择边界这两类权力。后者以“来源—机器—用途”关系为决策单元,通过身份认证、用途许可和接口权限把公开新闻转化为特定条件下可调用的新闻资源。
这一解释框架在于把候选集从技术前提重新还原为制度结果。新闻机构的局部否定权、基础设施平台的通用执行权和人工智能企业的候选集组织权共同构成资源边界,但三者并不对称,由此产生的资格性缺席也不同于排序意义上的不可见。换言之,某一新闻来源可能尚未进入比较,就已经失去参与生成式新闻生产的机会。因此,新闻公共性的分析不能只检验答案是否多样,还需追问多样性赖以成立的来源资格如何形成。
需要说明的是,资源把关并不天然导向生成式新闻答案的封闭或集中。可验证身份、稳定署名和更新接口可以增强来源责任与价值回流。只有当这些要求以高成本、私有化且不可申诉的方式实施时,它们才更可能把组织能力固化为资格差异。因此,治理的关键不是取消准入,而是使准入具备透明性、比例性、互操作性和基本的程序救济。新闻公共性的未来,在于把这种分配从黑箱化的技术门槛转为可争辩、可问责的公共秩序。也正因如此,后续研究需要同时追踪智能体模型输出、候选集边界与新闻机构的准入制度,评估新闻资源的资格性缺席,比较不同治理安排的实效,并探索开放接口、公共索引、可携带信誉与集体授权等替代性基础设施。唯有如此,智能新闻中的多样性才不会是模型输出的偶然结果,而能成为获得制度保障的公共价值。
【本文为广东省社科联2025年度“三类基地”专项课题(批准号:25JDZX02)成果】
参考文献:
[1] Guaglione S. Reuters and Time adopt bot-blocking whitelists to rein in AI crawlers[EB/OL]. (2026-06-09)[2026-08-02]. https://digiday.com/media/reuters-and-time-adopt-bot-blocking-whitelists-to-rein-in-ai-crawlers/.
[2] Reuters launches Model Context Protocol server to bring trusted news directly into customers’ AI workflows[EB/OL]. (2026-07-08)[2026-08-02]. https://www.reuters.com/media-center/reuters-launches-model-context-protocol-server-bring-trusted-news-directly-into-2026-07-08/.
[3] Fletcher R. How many news websites block AI crawlers?[EB/OL]. (2024-02-22)[2026-08-13]. https://reutersinstitute.politics.ox.ac.uk/how-many-news-websites-block-ai-crawlers.
[4] Shoemaker P J, Vos T. Gatekeeping Theory[M].New York: Routledge, 2009.
[5] Barzilai‐Nahon K. Toward a theory of network gatekeeping: A framework for exploring information control[J]. Journal of the American Society for Information Science and Technology, 2008, 59(9): 1493-1512.
[6] Wallace J. Modelling contemporary gatekeeping: The rise of individuals, algorithms and platforms in digital news dissemination[J]. Digital Journalism, 2018, 6(3): 274-293.
[7]毛湛文,孙曌闻.从“算法神话”到“算法调节”:新闻透明性原则在算法分发平台的实践限度研究[J].国际新闻界,2020,42(7):6-25.
[8] Zwingmann N, Hoffmeister E I, Engert S, et al. Generative AI as a gatekeeper: uncovering affordance-based gatekeeping mechanisms in media ecosystems[J]. International Journal on Media Management, 2026: 1-37.
[9]陈昌凤,肖鹏.重构信息入口:生成式把关的权力逻辑及其媒介生态影响[J].中国编辑,2026(04):62-68.
[10]何天平.重构“界面”:人机交互作为数字媒体文化的新语法[J].福建师范大学学报(哲学社会科学版),2025(01):86-94.
[11] Ross Arguedas A A. Emerging uses of AI chatbots for news and what it means for journalism[EB/OL]. (2026-06-16)[2026-08-15]. https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/emerging-uses-ai-chatbots-news-and-what-it-means-journalism.
[12]常江,刘亮.智能新闻伦理检视:基于新闻对话机器人生态角色的分析[J].青年记者,2026(04):64-73.
[13] Guaglione S. Reuters and Time adopt bot-blocking whitelists to rein in AI crawlers[EB/OL]. (2026-06-09)[2026-08-15]. https://digiday.com/media/reuters-and-time-adopt-bot-blocking-whitelists-to-rein-in-ai-crawlers/.
[14] Partnership with Axel Springer to deepen beneficial use of AI in journalism[EB/OL]. (2023-12-13)[2026-08-08]. https://openai.com/index/axel-springer-partnership/.
[15] Global news partnerships: Le Monde and Prisa Media[EB/OL]. (2024-03-13)[2026-08-08]. https://openai.com/index/global-news-partnerships-le-monde-and-prisa-media/.
[16] Allen W, Newton S. Introducing pay per crawl: Enabling content owners to charge AI crawlers for access[EB/OL]. (2025-07-01)[2026-08-12]. https://blog.cloudflare.com/introducing-pay-per-crawl/.
[17] Van der Vlist F N, Helmond A, Burkhardt M, et al. API governance: The case of Facebook’s evolution[J]. Social Media+ Society, 2022, 8(2): 20563051221086228.
[18]杨奇光,张宇.“机器信源”视角下新闻真实认识论危机及其检视[J].中国出版,2025(18):11-17.
[19] Carlson M. Automating judgment? Algorithmic judgment, news knowledge, and journalistic professionalism[J]. New Media & Society, 2018, 20(5): 1755-1772.
[20] Plantin J C, Lagoze C, Edwards P N, et al. Infrastructure studies meet platform studies in the age of Google and Facebook[J]. New Media & Society, 2018, 20(1): 293-310.
[21] Nechushtai E. Could digital platforms capture the media through infrastructure?[J]. Journalism, 2018, 19(8): 1043-1058.
[22] Barzilai‐Nahon K. Toward a theory of network gatekeeping: A framework for exploring information control[J]. Journal of the American society for information science and technology, 2008, 59(9): 1493-1512.
[23]张洪忠,王競一.机器行为范式:传播学研究挑战与拓展路径[J].现代传播(中国传媒大学学报),2023,45(1):1-9.
[24] Bucher T. Want to be on the top? Algorithmic power and the threat of invisibility on Facebook[J]. New Media & Society, 2012, 14(7): 1164-1180.
[25] Helberger N. On the democratic role of news recommenders[J]. Digital Journalism, 2019, 7(8): 993-1012.
[26] Brantner C, Karlsson M, Kuai J. Sourcing behavior and the role of news media in AI-powered search engines in the digital media ecosystem: Comparing political news retrieval across five languages[J]. Telecommunications Policy, 2025, 49(5): 102952.
本文引用格式参考:
常江,刘亮.资源把关:生成式人工智能的新闻调用及其治理[J].青年记者,2026(10):60-67.
责任编辑:焦力