
“美国搞科研、中国造爽剧”?这场对比从一开始就错了
潮新闻 2026-10-26 08:12:23
“国内一半算力都在造爽剧?”最近,这一说法在社交平台持续发酵。
其依据是一组被广泛引用的数据:AI短剧与视频生成占国内Token消耗的55%。部分网友调侃:美国AI在搞科研,中国AI只会喂爽剧,并因此抨击中国AI发展“不务正业”。
网传数据可靠吗?这笔账能这么算吗?记者进行了追踪。
55%这个数,哪来的?
55%,这数据从哪里来的?记者留意到,很多人引用了中文在线发布的内容。
作为A股上市公司,中文在线在6月份的一份投资者关系活动记录表中披露,“AI短剧成为第一大Token消耗场景”。其中写道,“在国内所有Token消耗份额中,AI短剧与视频生成高居首位,占比高达55%;其次是电商与营销(如直播带货、广告营销等),占比24%;而此前因Vibe Coding(氛围编程)流行而被寄予厚望的软件开发领域,在Claude等编程能力的推进下也仅占15%。AI短剧与视频生成的Token消耗量已达到软件开发的两倍以上,成为整个Token经济学中绝对的第一大核心消耗场景。”
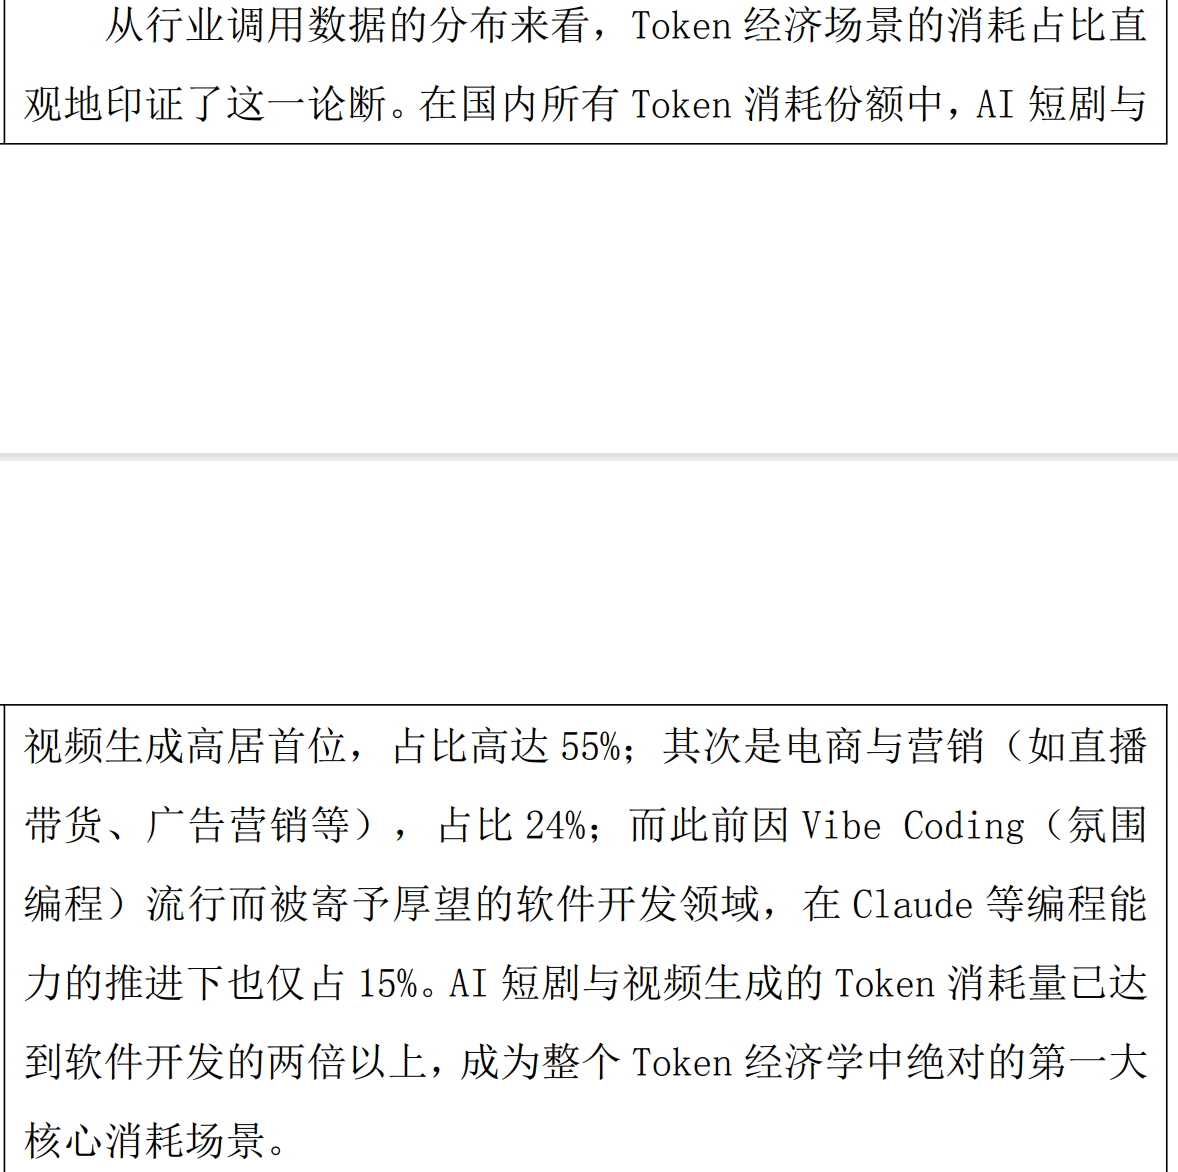 中文在线集团股份有限公司公布的《投资者关系活动记录表》截图
中文在线披露的这组占比数据,在该段文字开头中仅写了“从行业调用数据的分布来看”,并未提及数据具体来源。记者通过电话、邮件等形式试图联系该集团,了解数据如何得出,但截至发稿前仍未收到回应。
那这些数据还有其他出处吗?通过搜索,记者发现,2026年9月中国信息通信研究院云计算与数字化研究所发布的《词元(Token)经济发展研究报告(2026年)》中,提到“从落地实践来看,短剧与电商营销领跑词元消耗,验证词元经济的商业化路径。AI短剧与视频生成已成为词元消耗的核心应用引擎,占据全行业词元消耗份额的55%,位列第一;AI营销与电商占比24%紧随其后。”
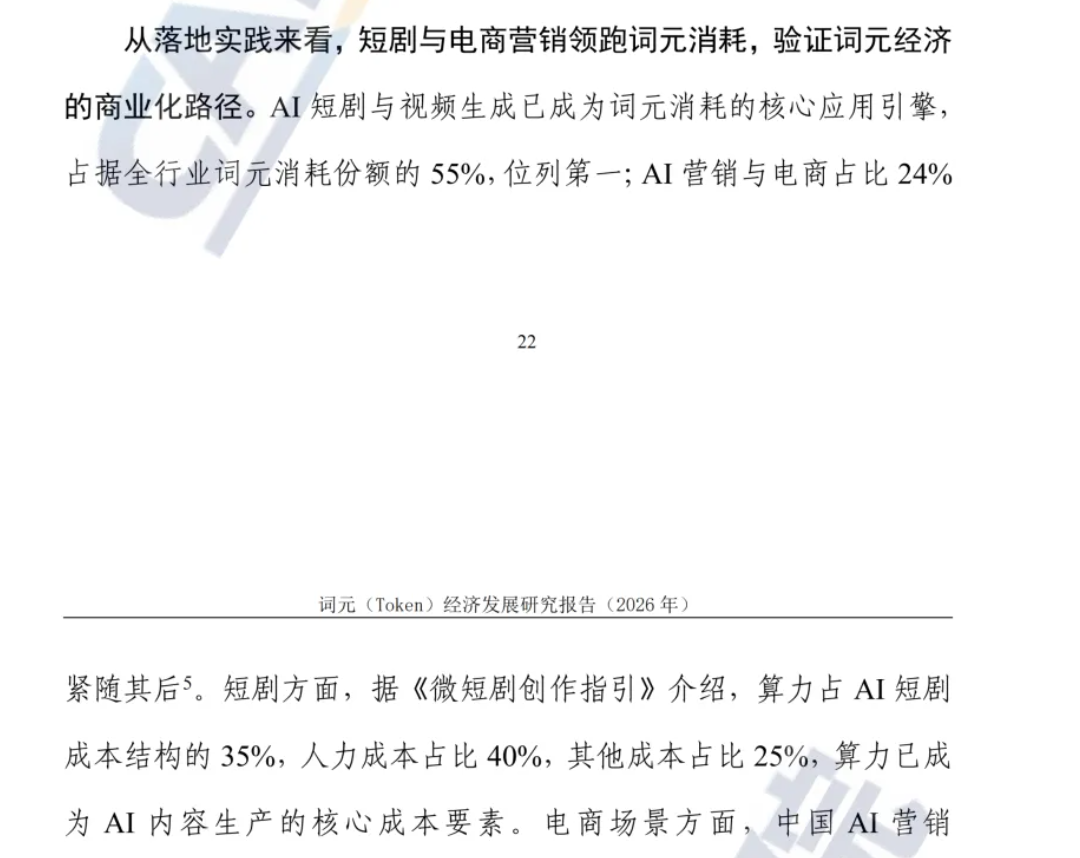 中国信息通信研究院云计算与数字化研究所发布的《词元(Token)经济发展研究报告(2026年)》截图。
在这份报告中,注明这组数据来源于中泰证券研究所的《Token经济学:AI时代的新生产要素与产业重构——2026年AI应用系列深度报告(五)》。记者也找到了这份2026年5月20日的报告,但在这份报告中仅提到“在应用落地层面,Token经济率先在AI剧、营销与电商实现规模化变现”,在提到AI剧时指出,“Token消耗占生产成本近半”。
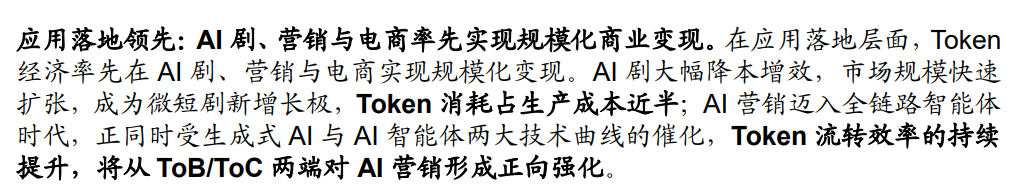 中泰证券研究所的《Token经济学:AI时代的新生产要素与产业重构——2026年AI应用系列深度报告(五)》截图。
据上海证券报报道,今年7月,在部分投资交流平台上流传着一段据称来自中泰传媒互联网团队的观点材料,该材料提及,2026年上半年的B端推理Token消耗Top2场景为短剧/视频(55%)和营销(24%)。但这份材料的统计口径明显小于“全国”范围。
至于“美国约58%的Token算力用于编程开发和企业自动化”,记者检索发现,该数据来源于自媒体层层转发的一位海外自媒体博主发言,同样找不到数据出处。
就算有55%,能等于“一半算力造爽剧”吗?
对于这组数据的可信度,业内专家也多持怀疑态度。
“尽管阿里云、火山引擎及腾讯云等云厂商掌握着自家MaaS(Model-as-a-Service,模型即服务)平台内大模型的调用词元(Token)数据,但这仅反映公有云MaaS这一局部市场的状况。受统计口径局限、私有化/端侧推理不可观测等因素制约,目前无法直接用厂商计费数据得到全国Token消耗的精确总量。”长期观察AI产业的数字经济智库高级研究员佘宗明表示,厂商数据并不等同于中国Token消耗的宏观总量。更何况,由于很多中国程序员用的是前沿闭源模型,这部分消耗未必会反映在国内的Token消耗账单上,所以中国人的Token使用量和中国的Token消耗量也是两个概念。
10月19日,字节跳动旗下产品豆包的公关负责人刘星在个人微博上发文称:“某公司发布的这个算力数据有些不靠谱,就字节来说,我们公司的总算力中,只有约10%,用于视频生成模型的训练和推理。”
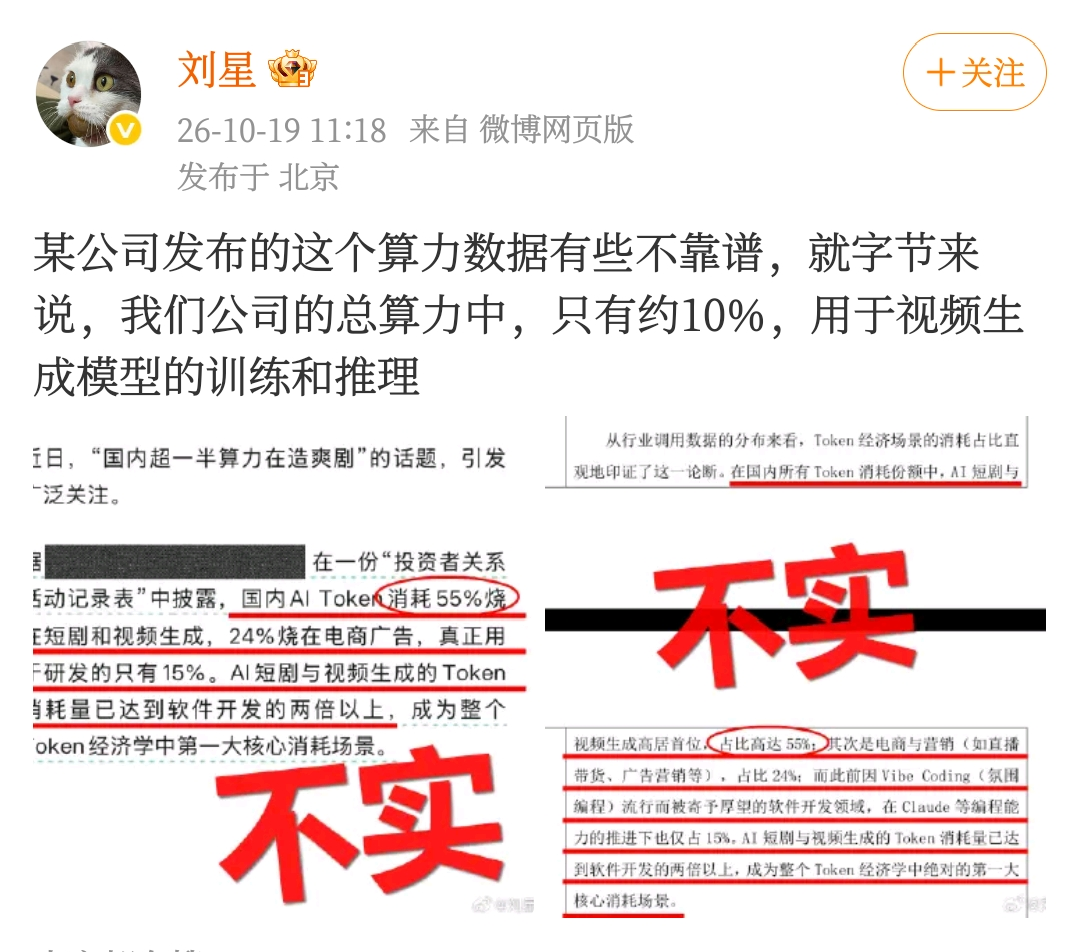 字节跳动旗下产品豆包的公关负责人刘星微博截图。
记者也向部分Token服务平台和智算中心了解了其Token的消耗情况。
“我们的主要客户主要是三大类,外贸服务企业、AI短剧企业和科技型企业。”某Token服务平台相关负责人表示,目前平台的核心用户以前两类公司为主,外贸服务企业主要利用AI生成多语言产品文案、搭建海外营销网站;AI短剧企业则利用大模型生成分镜、视频内容,发布至短视频平台获取流量收益。“科技企业目前多处于逐步导入期,这类企业一般倾向于先小规模测试验证效果,再全面切换”。
“目前,浙东南人工智能与大数据研究院和本地模塑产业相关企业是我们的重要服务对象。”浙东南智算中心公共事务总监牟徐宏介绍,2023年,随着国家逐步布局算力工程,台州抢抓机遇率先启动了浙东南智算中心建设。2024年,中心正式对外运营,目前一期已投用算力400P,相当于超过20万台高性能电脑同时运转的庞大算力。
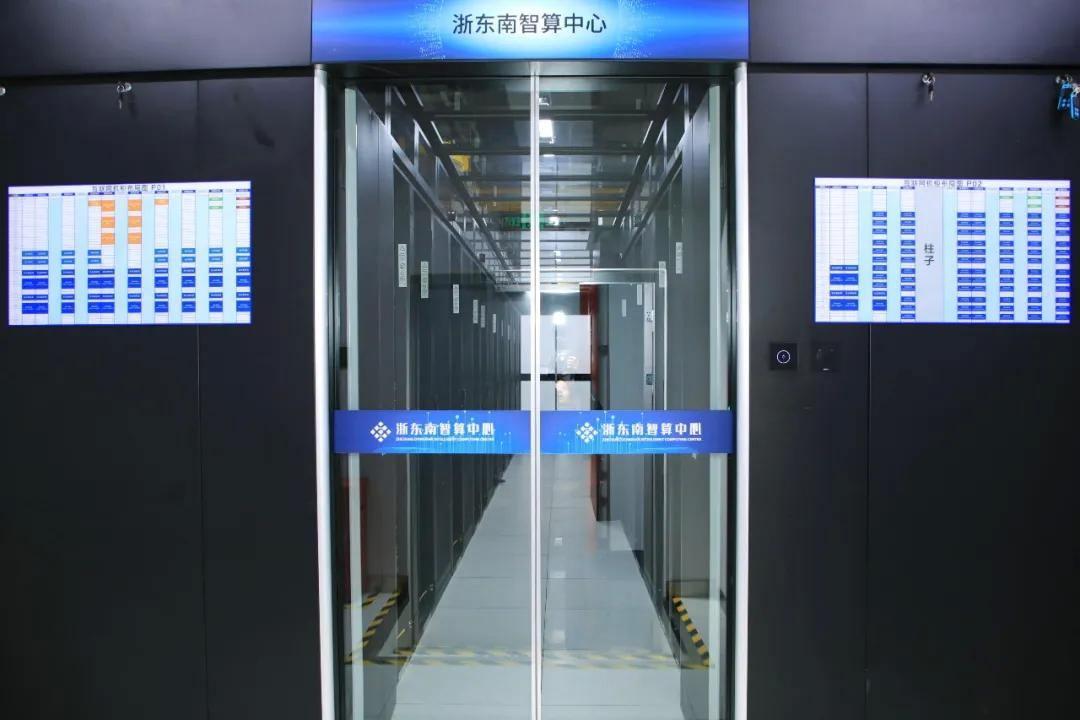 浙东南智算中心。图源:台州发布
“对我们来说,智算中心就像一个随取随用的算力仓库。”浙东南人工智能与大数据研究院运营负责人陈梦岚说,研究院需要开发和运行各类工业智能体,来解决模具设计、生产质检等具体问题,便租赁了智算中心的6台服务器,目前,所有计算任务都从智算中心的算力库中按需调用。
在“国家队”方面,据报道,截至今年9月底,2021年1月1日正式投入运营的国家超级计算成都中心累计完成高精度科学计算任务超1.8亿项,综合算力利用率超过78.4%,服务用户超过2100家。
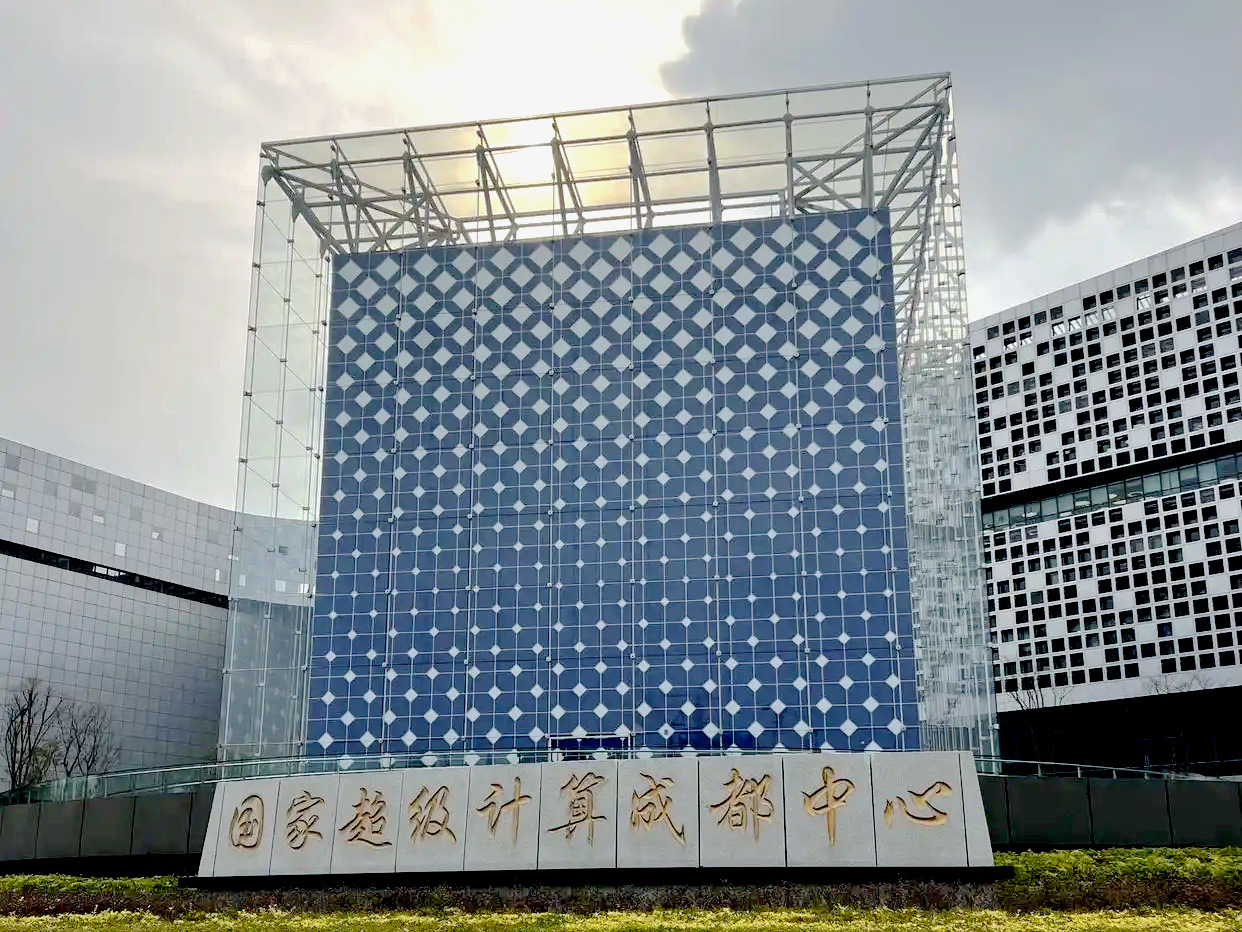 国家超级计算成都中心。图源:川观新闻
“其实Token消耗量与算力分配,与国家科技竞争力投入,这三者之间是不能画等号的。”佘宗明进一步指出,Token是模型处理信息的计量单位,反映的是调用量,简而言之是模型“吞吐”了多少内容;而算力是物理硬件的计算能力。针对不同任务,Token对应的算力消耗也并不对等。
算力做短剧,真是浪费吗?
虽然数据来源不靠谱,甚至Token消耗量并不能代表算力投入分配,但这类消息一出,依然可以挑动起公众的情绪。
这种对算力流向的焦虑究竟从何而来?一方面,大众真切感知到算力资源的稀缺;另一方面,部分AI短剧同质化、粗制滥造的现象,早已引发公众反感。因此,当“一半算力造爽剧”的数据流出,大众的情绪便被迅速点燃。然而,在这层情绪背后,还横亘着一道技术认知的门槛——毕竟,许多人并不了解,代码Token与视频Token在计量单位上本就存在巨大差异。
国家信息中心信息化和产业发展部主任单志广发文指出:“算力分为基础算力、智能算力和超算算力三种类型:基础算力面向基础通用计算;超算算力的高精度数值计算主要用于科学与工程计算等高端领域;智能算力则面向人工智能计算,是支撑人工智能技术和产业发展的“最优解”。”
同时单志广还强调:“算力网和物联网一样,需要有真实的应用场景牵引,根据实际应用需求进行分级、分域、分区的互联互通。如果没有真实的应用场景牵引,就没有对算力设施进行普遍互联的需求;没有业务应用支撑,算力设施就无法发挥应有作用,反而会造成设施空置和能源空耗。”
这其实就证明了场景的重要性,而AI短剧正是真实的应用场景。
在供给端,中国在视频生成、多模态模型方面处于领先地位,这类大模型更适配短视频、短剧等内容制作需求。同时,中国作为全球最大的互联网内容消费国,中国用户也已经培养了为短剧付费的习惯。所以中国依托国内市场优势,选择从AI短剧场景应用切入,通过商业化闭环获取现金流,反哺底层技术研发,是跑通了一套完整的逻辑,反而有利于相关技术进一步发展、迭代。
事实上,这种“娱乐反哺科技”的逻辑不仅体现在商业变现上,更体现在底层技术的相互交融中。中国科学院科技战略咨询研究院研究员周城雄就曾公开表示,在进入“超级数字场景”后,科技与游戏的界限将越发模糊。“下一步计算能力的提升(有助于)游戏的进步,也带来科技的进步,而科技的进步也使得游戏得以提升。”周城雄说。
实际上,算力巨头英伟达在发展早期,也是依靠游戏显卡业务逐步壮大,并在此过程中积累了GPU技术和计算生态,为后来向人工智能领域拓展奠定基础。
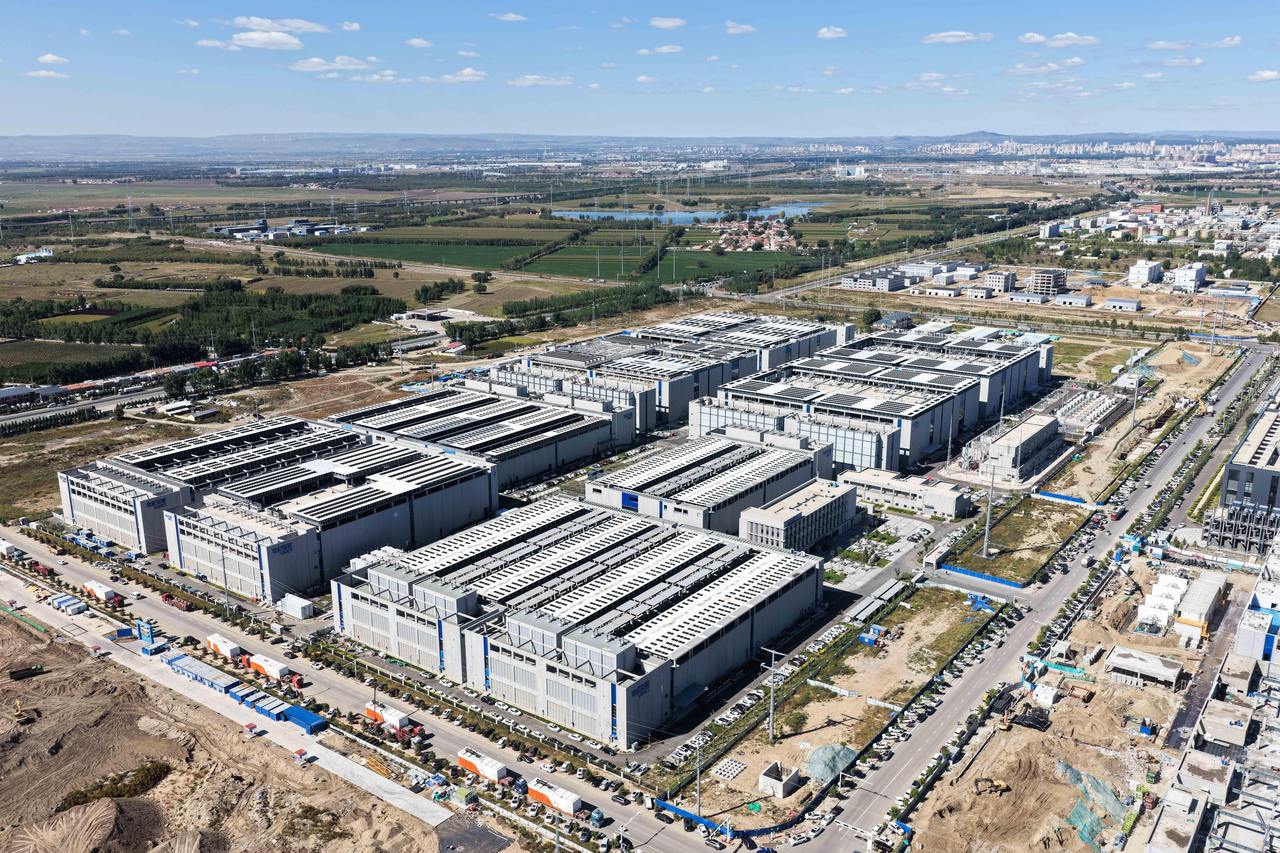 这是9月10日拍摄的世纪互联乌兰察布云智算中心一号基地(无人机照片)。图源:新华社
回看这场“算力造爽剧”的争议,从数据来源的模糊不清,到样本偏差的以偏概全,再到算力类型分化的认识误区,每一个环节都经不起推敲。
所以与其焦虑“算力被浪费”,不如关注如何让算力在科研、工业、内容创作等多元场景中各尽其用——毕竟,没有场景牵引的算力设施,才是真正的浪费。
责任编辑:韩雨婷