
AI干了多少活?“Token+”把账算明白了
大众新闻 胡沥中 2026-10-26 18:47:56原创
近日,2026人工智能产业大会在济南举办,神思电子作为济南市人工智能链主企业参加本次大会。
从技术展示走向业务应用,企业既需获取适用的AI能力,也需明确使用成本,并根据业务时效选择服务。围绕这一需求,神思电子数算法全要素融合调度平台提出“Token+弹性算力计费”方案,尝试在Token计量之外,引入有效计算时长和算力档位,使费用与资源投入的关系更加清晰。
Token计费有局限
在代码行数和输出量相同的情况下,查找1个BUG与10个BUG,所需的计算投入可能不同。
生成质量相同的济南三日游攻略,耗时20秒与30秒,体现了不同的服务时效。
AI用户关注任务完成质量、响应时间和使用成本。仅按Token量计价时,即使算力投入和服务速度不同,相同输出量仍可能对应相同费用。
Token是模型处理文本的计量单位,可以反映处理内容的数量,但难以完整衡量任务的算力消耗。
数算法全要素融合调度平台提出的“Token+ 弹性算力计费”方案,旨在使计费更加透明:在Token计量的基础上,补充有效计算时长,并提供不同算力档位供用户选择。
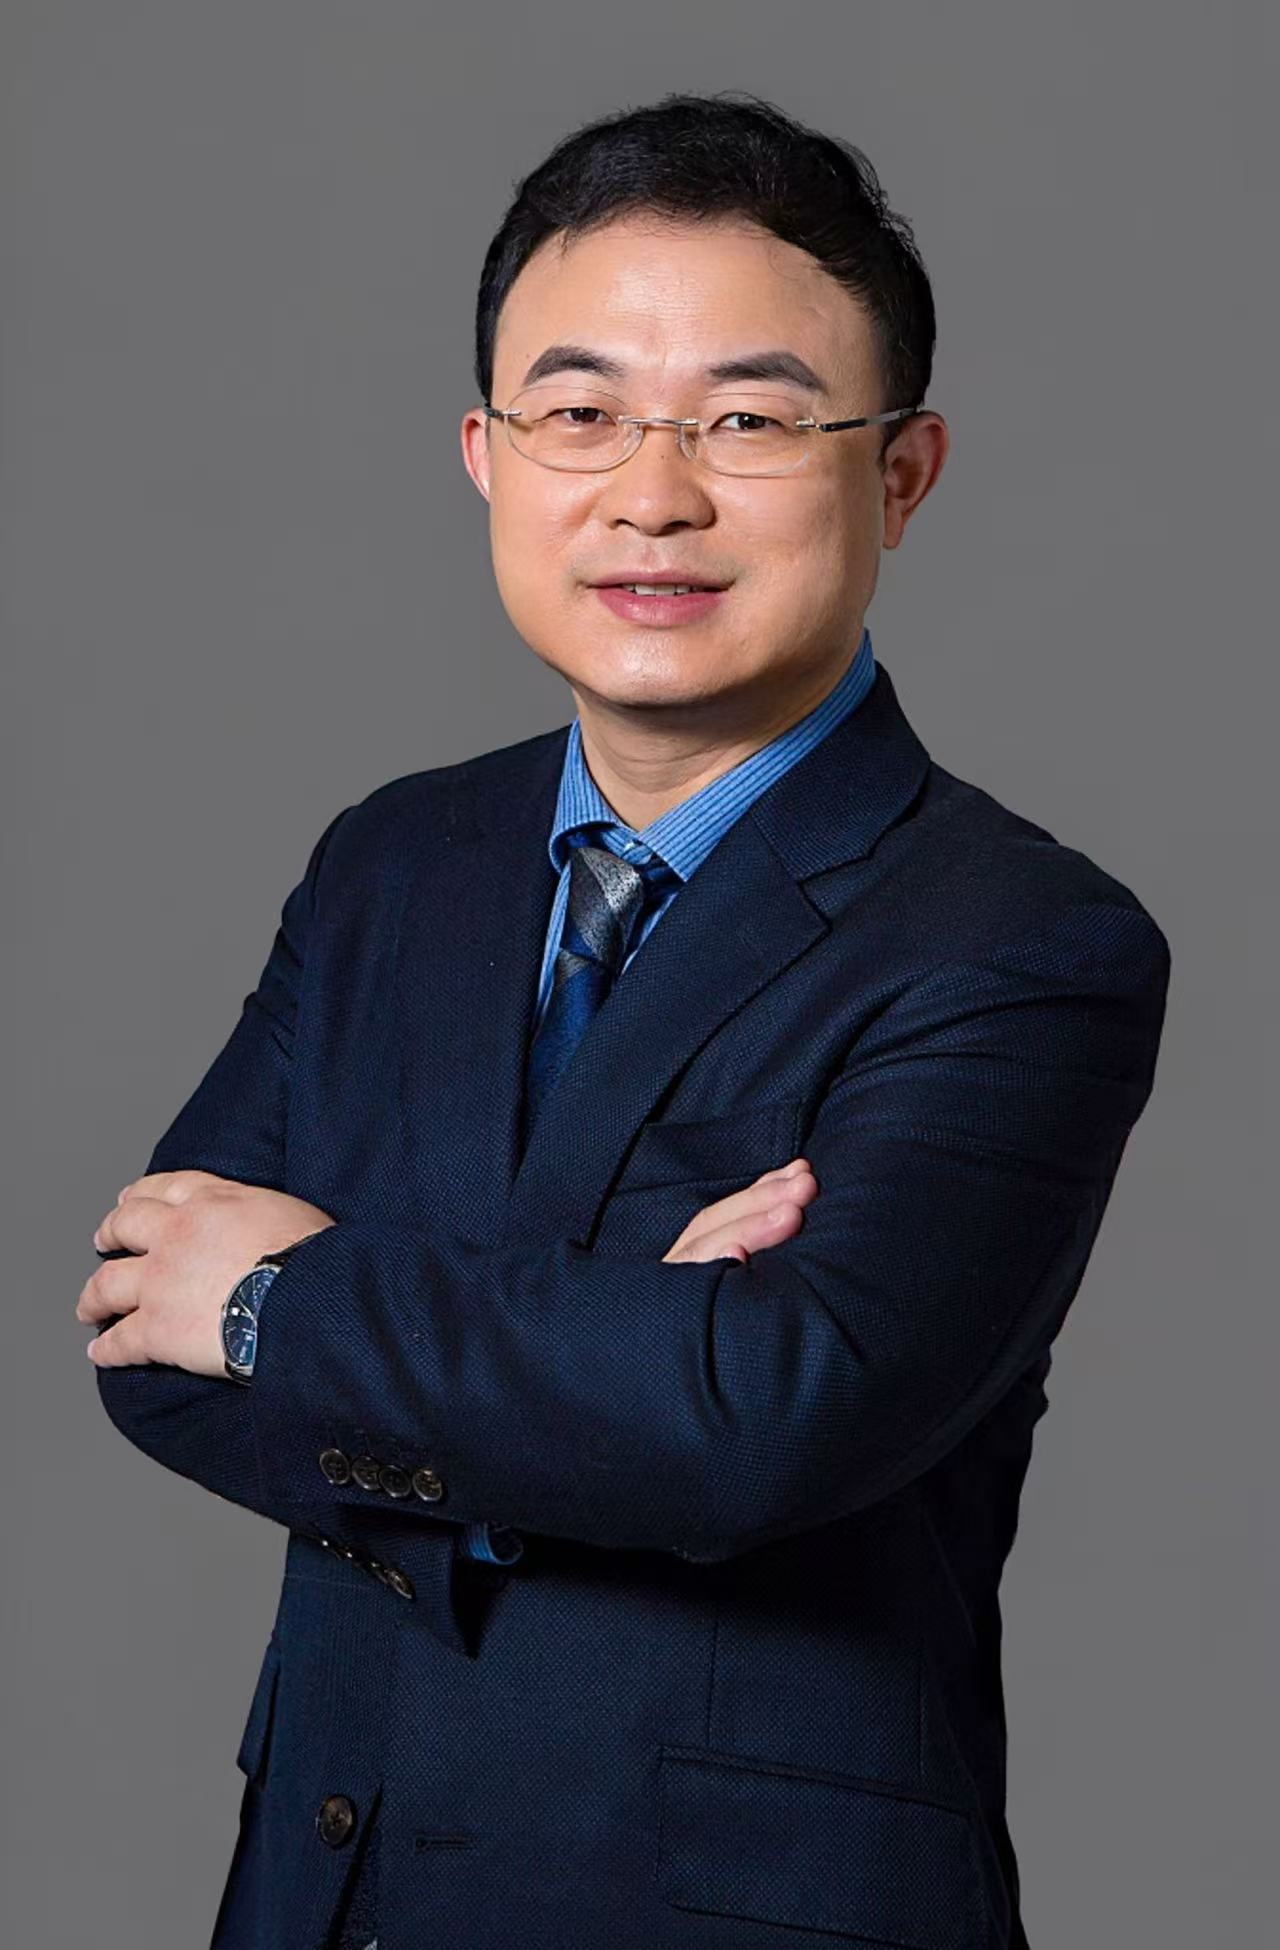
神思电子首席科学家闵万里博士介绍,按量计费、按时补充、按档选择,可在Token用量之外,进一步明确算力成本及服务时效档位。
输出量相同 计算投入可能不同
以代码查错任务为例。
假设使用同一模型、同样的算力配置,从同样行数的代码中找BUG,按相同的质量要求输出原文和标注,最终都输出1000个Token。其中,找1个BUG有效占用算力10秒,找10个BUG占用30秒。
如果只按输出Token计费,单价按照每百万Token 8元,两次调用都是0.008元。
对用户而言,较低的算力消耗未能体现为价格差异;对服务商而言,更多的计算投入也未能体现为相应收入。
“Token+”在适当降低Token基础单价的同时,将有效计算时长纳入账单。
轻量任务因算力消耗较少,有望降低费用;计算资源占用时间较长的任务,则按公开费率计费。这有助于用户核对算力支出,也使服务商收益与资源消耗更加匹配。
这并不意味着每次调用都会降价,而是使不同任务的计算投入差异在账单中得到体现。
排队等待、网络传输,以及平台故障导致的重试和异常等待,不应计入用户费用。用户等待的总时长不能直接作为计费时长。
按业务时效需求选择算力档位
再以响应速度为例。
以生成济南三日游方案为例,假设调用同一模型,回答质量一致,均输出1000个Token。一种算力配置需要30秒,另一种需要20秒。按上述Token单价,两次调用费用均为0.008元。
用户对响应时间的要求不同:实时需求更重视服务速度,时效要求较宽松的任务则可优先考虑成本。
因此,“Token+”拟为同一个模型提供不同的算力档位。
经济型侧重成本控制,适合批量处理、离线分析等时效要求较宽松的任务。高性能型配置相应的加速硬件与服务资源,面向更看重响应速度、并发处理能力的业务。
在旅游攻略示例中,经济档可设为30秒、0.006元,高性能档可设为20秒、0.008元。当然,上述价格仅用于说明档位选择,具体费用取决于相应档位的定价规则。
用户可根据业务需求,在经济档与高性能档之间权衡预算和时效。
“Token+ 弹性算力计费”旨在为轻量任务提供更经济的使用方式,使复杂任务的计算投入有据可查,并为同一模型提供不同算力服务选择。
按Token计量计费,便于核算模型服务用量。单一Token用量难以完整反映资源消耗,“Token+ 弹性算力计费”进一步考虑不同算力配置的消耗及用户的时效需求,有助于提高计费透明度。
(大众新闻记者 胡沥中)
责任编辑:胡沥中